码农戏码

新生代农民工的自我修养

0%

2024年被认为是AI应用落地的元年,AI开始在日常生活、智能终端落地,2025年则被行业认为是智能体(Agent)元年,AI从“听令行事”到能“主动服务”了,行业相关的产品也越来越丰富。

AI 发展很快,跟朋友交流 AI 的一些处理方案时,发现很多关于记忆、上下文不管什么语言基本都是类似套路的通用方案,朋友好奇为什么没人去沉淀为框架?
其实原因很简单,AI 发展太快了,大佬们也都在探索和尝试,现在去沉淀 一是没有精力 二是还不稳定,一切都是变化中。

回顾 Spring ,发展了多少年,在 Spring 之前出了多少框架,最后才让 Spring 一统江湖。

作为开发,来看看天天使用的一些开源框架怎么引入 AI ,或者来感受一下作者的 AI 焦虑感

不靠近他就没法了解他,太靠近他又会被伤害,技术学习也是一种投资,投资早了可能后面技术被淘汰了,浪费精力;投资晚了又可能别人都起飞了你还不知何物。

Arthas

Java 应用的线上诊断“瑞士军刀”,能让你在不重启服务的情况

年初看到阿里博客 arthas-agent,运维相当高效,所以想引入一下。

特意找了阿里朋友,原来 arthas-agent 只在内部使用,但外部可以借助 arthas MCP 自行搭建 agent

[Agent开发-对接arthas mcp server]

这就是引入 AI 的第一种方式:提供 MCP Server

MCP 的主要目的在于解决当前 AI 模型因数据孤岛限制而无法充分发挥潜力的难题,MCP 使得 AI 应用能够安全地访问和操作本地及远程数据,为 AI 应用提供了连接万物的接口

XXL-JOB

第一眼看到 xxljob 的 release log,就觉得很神奇,一个任务调度系统,这么纯粹的系统,怎么要引入 AI? 有什么神奇的地方

从 3.1.0 开始,它多接了一类任务:到点以后,不是只去跑一段 Java 或一条 SQL,还可以去问本地大模型、去跑一条 Dify 工作流,或者把一段话交给 OpenClaw。调度中心还是原来的调度中心,变的是执行器这一侧,AI 被收成了普通的 Bean 任务

翻阅了下源码,里面只是把调用大模型底层代码做了一些封装。方便各种 AI 的调用。
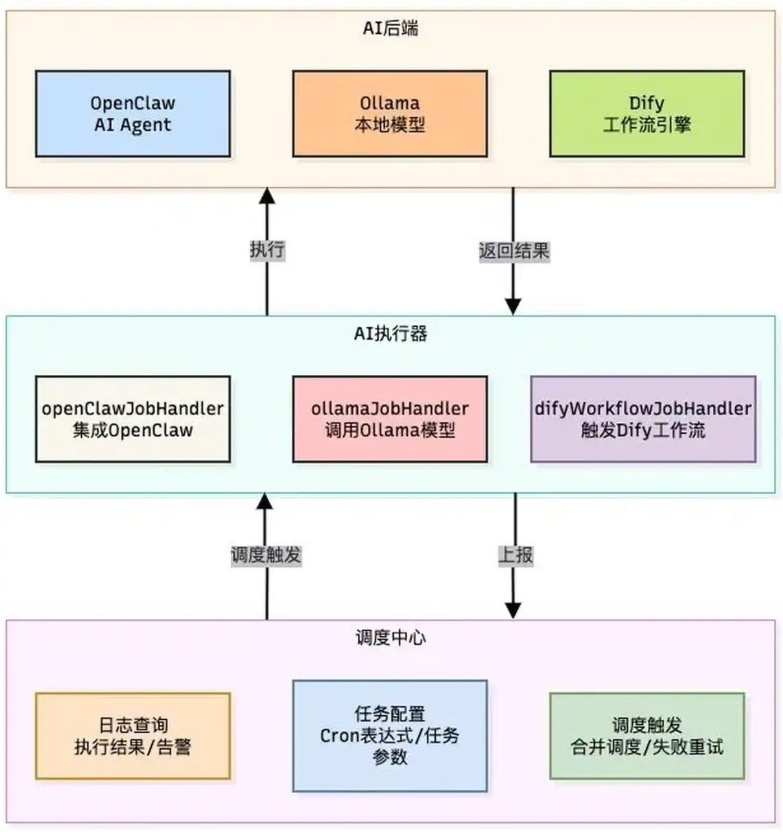
比如 ollamaJobHandler: OllamaChat任务,支持自定义prompt、input等输入信息。

示例任务入参如下:

1
2
3
4
5
{
"input": "{输入信息,必填信息}",
"prompt": "{模型prompt,可选信息}",
"model": "{模型实现,如qwen3.5:0.8b,可选信息}"
}

可以看出作者对 AI 跟踪,相当紧密。最早的 OpenClaw 都适配了

对作者这种精神很钦佩,但 但 个人感觉很没有必要。猜测作者有 AI 焦虑。

回头看,现在有几人还记得 OpenClaw? 后面大概率还得把这个踢除

再者,一个业务系统 对于 AI 的诉求 怎么只会在任务调度,作为主流 Spring 体系下,引入 spring-ai 不是更香吗? 谁会从一个辅助系统去引入一个未来的 AI 体系

再者,引入 AI 希望调用大模型更方便,同理,那当初为什么不去 内置实现一个 ORM 来执行一次 SQL

这是引入 AI 的第二种方式:提供底层大模型调用封装

LiteFlow

发现这个,是因为之前解决 [LiteFlow线程池饥饿死锁.md] ,深入理解框架原理和特性。

发现了作者对 AI 的理解以及应用

一、首先有一个 AI Skill , How2useLiteFlow

AI 对 LiteFlow 只是「一知半解」。它的训练语料里 LiteFlow 的内容既不全也不新,遇到不确定的地方又倾向于「编一个看起来对的」,于是生成出跑不起来、甚至误导人的代码。

How2useLiteFlow 就是为了解决这个问题——它是一个让 AI 正确使用 LiteFlow(v2.16.X) 的 Agent Skill (opens new window)。装上它之后,你的 AI 在写 LiteFlow 相关代码时,会以官方文档与源码蒸馏出的知识为准,不杜撰、不拿网络内容充当 LiteFlow 的行为依据。

二、AI Agent

过去五年,LiteFlow 始终在回答同一个问题:当业务逻辑越来越庞杂,我们该如何把它组织得清晰、可控、可复用?我们给出的答案是”编排”——把一个个独立的逻辑单元,用一套简洁的表达式自由地串联、并联、嵌套起来。

整个软件世界正在被同一股力量重新塑造:AI 正在从一个可选项,变成业务系统里一个绕不开的角色

这一两年,AI 这个词已经被说烂了。但凡一个框架、一个产品,不挂上点 AI 都不好意思发版。
所以请允许我们先把丑话讲在前头:这次 2.16.0 带来的,并不是一个”大模型组件”。

其实在 2.16.0 之前,就已经有不少公司用 LiteFlow 在跑 AI 业务了——他们在自己的组件里直接调用大模型,LiteFlow 则在背后充当后端编排引擎,把一次次模型调用串成完整的业务链路。这条路一直走得通,我们也无意去抢它:今天调一次大模型实在太容易了,new 一个 client、发个请求,我们再官方包一个”大模型组件”出来,纯属画蛇添足。

我们这次想做的,是另一件本质上完全不同的事——把 Re-Act Agent 做成 LiteFlow 的组件。

总结

AI 的确加剧了人的焦虑,而且减少社会变革的适应时长。不像以前从马车到火车,有一段时间来让人类适应,而 AI 带的时间压迫很强烈。

一个要被 AI 淘汰的程序员,还得无奈研究 AI 。
像对中医和西医的区别,西医就是让人明明白白地死去,而中医却让人糊里糊涂地活着

最近看到 Kafka 有人也在暴露 MCP,未来会不会这样的,所有组件包括业务系统,都要提供 MCP,让大模型去理解和调度,在 Harness 的保障下 最终系统稳定运行

就像芯片厂,不管是光刻机,还是晶圆抓手都是设备,这些设备都要联通 EAP,让EAP去统一管理调度,安全高效地生产芯片。
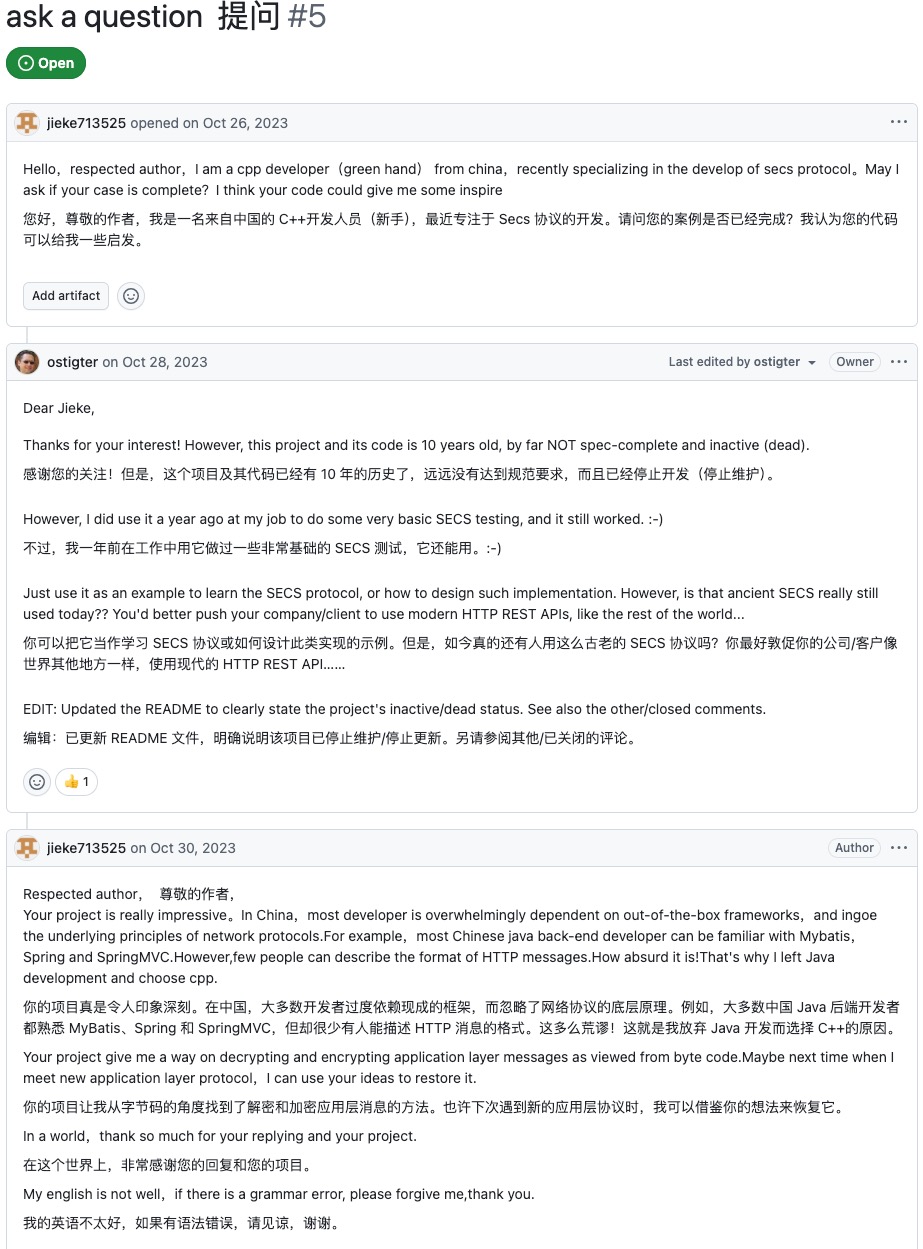
最近工作中碰到 SEMI

查阅资料时,翻到一个 C++ 程序员的发言

在中国,大多数开发者过度依赖现成的框架,而忽略了网络协议的底层原理。例如,大多数中国 Java 后端开发者都熟悉 MyBatis、Spring 和 SpringMVC,但却很少有人能描述 HTTP 消息的格式。这多么荒谬!这就是我放弃 Java 开发而选择 C++的原因。

不得不承认,这名程序员说得没错,他希望能更关注底层的原理和实现,而不只是上层框架的使用。
这其实是一名技术人员朴实的追求,深挖原理,都希望从底层字节层面弄懂弄通
但任何生物、事物都为是了生存、繁殖。所以都会去适应环境,放低存活门槛。
回顾计算机语言发展,从开始的打孔、汇编、再到C 、现代高级语言,都是在迭代改进,放宽入门门槛,增大存活机率,实现普世价值

而现在 AI ,更是通过自然语言去实现编码能力。因此从大的视角
程序员分两类:
1、专业程序员,垂直深度,就像这名程序员追求的,提供专业的工具,像语言缔造者,底层协义设计
2、应用程序员,编码语言的使用者,随着 AI 加持,未来可能人人都是程序员的程序员

简单介绍一下 SEMI: 全称 Semiconductor Equipment and Materials International,国际半导体设备与材料协会

一座 300mm 晶圆厂,动辄上千台设备,来自数百家供应商。
如果没有统一规则,晶圆厂只有两条路:要么被单一供应商锁定,要么为每一台机台单独开发对接方案——两条路都是天文数字的成本

一台来自德国的设备、一片来自日本的硅片、一套来自美国的自动化软件,要在同一条产线上无缝协作——靠的就是 SEMI 标准。它不生产任何一颗芯片,却定义了全球每一座晶圆厂的运行方式。

在 1975 年之前,业内流传着 2000 多种不同的硅片规格,每家供应商按自己的喜好发货,设备商只能追着”移动靶”设计搬运机构。

在1975年,第一个标准项目异常朴素却价值巨大:统一硅片直径
标准发布后不到两年,约 80% 的硅片实现了统一。

SEMI 标准本质上把三件事固定下来:

物理上能对接

晶圆盒的尺寸和把手位置、装载口的机械接口、地脚的间距、超纯水管路的接头规格——全都写死在标准里。设备到场即可就位,不需要现场”量体裁衣”。

信息上能对话

设备与工厂主机之间用什么语言说、说什么内容,由 SECS-I / SECS-II / HSMS / GEM 一族标准定义。晶圆厂写一套 EAP(设备自动化程序),就能挂上所有符合 GEM 的机台。

商务上能替换

接口标准化之后,同一种工艺可由多家设备商供货,且软件无需重写。这是晶圆厂议价能力的技术基础——标准的本质是把”定制”变成”通用”。

SEMI 标准是半导体产业真正意义上的”通用语言”——不掌握它,你只能看到设备的黑箱;掌握了它,你才能看懂这条产线是怎么被组织和控制起来的。

“通用语言”,在DDD中的关键概念。

这次我碰到的是信息对话,EAP能与我们软件通信,需要实现 SECS 协议。 SEMI 中 关于 SECS 部分将近有 500页规范。从底层通信消息结构与数据项 到 上层的报文语义,再到设备行为状态转换

如果从零开始实现,就像告诉了你 HTTP 协议规范,要去实现一个 http server,开发一个tomcat

好在开源社区有相应的实现,所以我也只是个应用程序员,最多是专业程序的爱好者。去实现一套 SECS 难度还是很大的

https://github.com/ostigter/secs4j/issues/5

在分布式系统,尤其是微服务系统中,一次外部请求往往需要内部多个模块,多个中间件,多台机器的相互调用才能完成。在这一系列的调用中,可能有些是串行的,而有些是并行的。在这种情况下,我们如何才能确定这整个请求调用了哪些应用?哪些模块?哪些节点?以及它们的先后顺序和各部分的性能如何呢?

这就是分布式链路追踪技术(Distributed Tracing)要解决的问题。

分布式链路追踪是一种监控和诊断分布式系统中请求流程的技术。它通过记录和分析在一个请求过程中,各个微服务之间的调用关系、耗时等信息,帮助开发和运维人员理解系统的行为,快速定位问题所在。

思路

1、每个请求都使用一个唯一标识来追踪全部的链路显示在日志中,并且不修改原有的打印方式(代码无入侵)
2、使用Logback的MDC机制日志模板中加入traceId标识,取值方式为%X{traceId}

MDC(Mapped Diagnostic Context,映射调试上下文)是 log4j 和 logback 提供的一种方便在多线程条件下记录日志的功能。MDC 可以看成是一个与当前线程绑定的Map,可以往其中添加键值对。MDC 中包含的内容可以被同一线程中执行的代码所访问。当前线程的子线程会继承其父线程中的 MDC 的内容。当需要记录日志时,只需要从 MDC 中获取所需的信息即可。MDC 的内容则由程序在适当的时候保存进去。对于一个 Web 应用来说,通常是在请求被处理的最开始保存这些数据。

MDC使用

1
2
3

MDC.put(“traceId”, traceId); // 添加traceId
MDC.remove(“traceId”); // 移除traceId

在日志配置文件中 <pattern> 节点中以%X{trace-id}取出,比如:<pattern>

1
<property name="CONSOLE_LOG_PATTERN" value="%d{yyyy-MM-dd HH:mm:ss.SSS} [%thread] [%X{traceId}] %-5level %logger{50} %msg%n"/>

问题与挑战

上面 slf4j 原始提供的 MDC,实现原理是通过 ThreadLocal ,所以在单线程场景下,已经完全胜任

但在多线程下,就会出现 traceId 丢失问题。链路追踪就会中断

ThreadLocal 的一个基本特性:子线程拿不到父线程的值。 
主线程里MDC.put("traceId", "abc123"),
然后 @Async  开一个新线程去执行,新线程里MDC.get("traceId") 是 null。

解决

1、最差劲的解决办法,在业务代码中定义 traceId,手动传递。

2、要破除 ThreadLocal 只对当前线程有线的方法有两种:

一种是JDK自带的、ThreadLocal的扩展类InheritableThreadLocal,子线程会拷贝父线程中的变量值

一种是引入alibaba 的 transmittable-thread-local包的 TransmittableThreadLocal ( TTL )实现

TTL 原理

TTL 在提交任务时,先拍一个当前线程 TTL 变量的快照,然后把快照绑到任务上。
任务执行时,先把快照恢复到执行线程里,执行完再清理。

1
2
3
4
5
6
7
8
9
10
11
主线程 TTL: {traceId: "traceId-123qwe"}  
    │
    ├─ 提交任务 → TTL 拍快照
    │
    ├─ 异步线程开始执行
    │    └─ TTL 恢复快照 → {traceId: "traceId-123qwe"}
    │    └─ log.info() → traceId=traceId-123qwe
    │    └─ 执行完毕 → TTL 清理
    │
    └─ 主线程继续

全程不需要业务代码参与。你不需要在异步方法里做任何处理。

SLF4J 的 MDC 只是一个门面,真正存数据的是 MDCAdapter

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
public class MDC {

static MDCAdapter mdcAdapter;

static {
mdcAdapter = bwCompatibleGetMDCAdapterFromBinder();
}

public static void put(String key, String val) {
mdcAdapter.put(key, val);
}

public static String get(String key) {
return mdcAdapter.get(key);
}
}

所以我们需要自定义 MDCAdapter ,来增强默认 MDCAdapter 中使用的 ThreadLocal

自定义 TtlMDCAdapter类

基于上面 MDC 中的 static MDCAdapter mdcAdapter ,是个 package 访问权限。

所以要替换这个mdcAdapter,需要把 TtlMDCAdapter类 写在 org.slf4j包下

得创建一个 org.slf4j 包,来绕过 Java 访问权限机制

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23

package org.slf4j;

import com.alibaba.ttl.TransmittableThreadLocal;
import org.slf4j.spi.MDCAdapter;

public class TtlMDCAdapter implements MDCAdapter {
/**
* 此处是关键
*/
private final ThreadLocal<Map<String, String>> copyOnInheritThreadLocal = new TransmittableThreadLocal<>();

private static TtlMDCAdapter mtcMDCAdapter;

static {
mtcMDCAdapter = new TtlMDCAdapter();
MDC.mdcAdapter = mtcMDCAdapter; // 一定要在org.slf4j包下
}

public static MDCAdapter getInstance() {
return mtcMDCAdapter;
}

线程池必须统一用 TTL 包装

所有会执行异步任务的线程池都要包一层

1
ExecutorService ttlExecutor = TtlExecutors.getTtlExecutorService(originalExecutor);

TtlExecutors 解决“线程池怎么传”;
TtlMDCAdapter 解决“MDC 本身能不能被 TTL 传”。

替换TTL 版本

在 Spring 容器 refresh 之前,提前调用 TtlMDCAdapter.getInstance(),把 SLF4J MDC 底层的 MDCAdapter 替换成 TTL 版本

1
2
3
4
5
6
7
public class ApplicationInitializer implements ApplicationContextInitializer<ConfigurableApplicationContext> {

@Override
public void initialize(ConfigurableApplicationContext applicationContext) {
TtlMDCAdapter.getInstance();
}
}

完整链路

1
2
3
4
5
6
7
8
9
10
11
ApplicationInitializer 启动时注册 TtlMDCAdapter
↓
MDC.put() 落到 TransmittableThreadLocal
↓
线程池被 TtlExecutors 包装
↓
提交任务时捕获 TTL 快照
↓
子线程执行时恢复 MDC
↓
异步日志带上 traceId

改进项

这个方案是个通用方案,基本都是这么解决的

在 github 上,看到有人讲 TtlMDCAdapter 太丑陋了

TtlMDCAdapter is ugly, consider refactoring or removing it

https://github.com/trydofor/professional-wings/issues/187

我以为是提供了更好的方案,其实还没有跳脱出 slf4j 的限制

作者说 “TtlMDCAdapter is ugly” 的核心原因是:把一个业务类的实现放在 org.slf4j 包下太 hacky 了。 refactor 后,TtlMDCAdapter 回到了自己的包,TweakMDC 作为 org.slf4j 包下的”注入点”单独存在,职责分离更清晰。

1
2
3
4
5
6
7
8
public class TweakMDC {
public static void adapt(@NotNull MDCAdapter mdc) {
// init static block
var ignore = MDC.getMDCAdapter();
// replace current adapter
MDC.mdcAdapter = mdc;
}
}

最近又收到同事反馈 flow 卡住跑不动了

上一次遇到这类反馈,排查下来是【多线程饥饿死锁】导致的

本着同类问题不能再出现的原则,这次需要彻底排查根因,避免重蹈覆辙

整个flow是基于LiteFlow框架实现,为了性能,每个Flow创建一个线程池,每个节点 NodeComponent 内部使用多线程执行

伪代码:

1
2
3
4
5
6
7
8
9
10
11
12
Flow {
ThreadPoolExecutor nodeExecutor = new ThreadPoolExecutor

}

NodeComponent {
List<Task> taskList = new List();

taskList.add(task);

List<Future<TaskResult>> futures = nodeExecutor.invokeAll(taskList);
}

第一次卡住

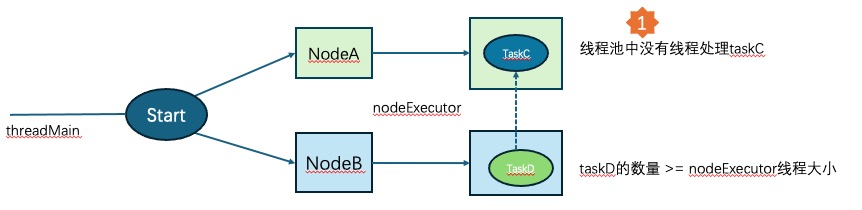
某个flow中,有个特殊的形态,Node 与 Node 之间会有逻辑依赖关系
如图,NodeD 会依赖 NodeC
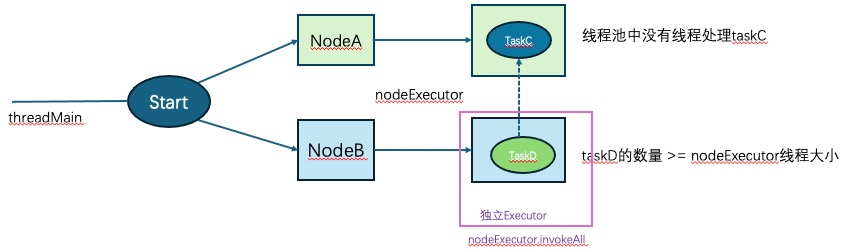
当 NodeD 任务数量超过线程池大小时,并且所有线程被分配给 TaskD 时,被依赖的 TaskC 处于资源饥饿
造成整个 flow 卡住

这儿卡住的两个条件:
1、任务数量超过了线程数量
2、所有线程都被分配给了 TaskD

解决:

对于 NodeD ,使用独立线程池,不再使用flow全局线程池,线程池隔离
这样 NodeC 和 NodeD 的线程池竞争关系就没有了

第二次卡住

这次卡住,对照 flow 分析,底层道理是一样的,只是表现形式不一样

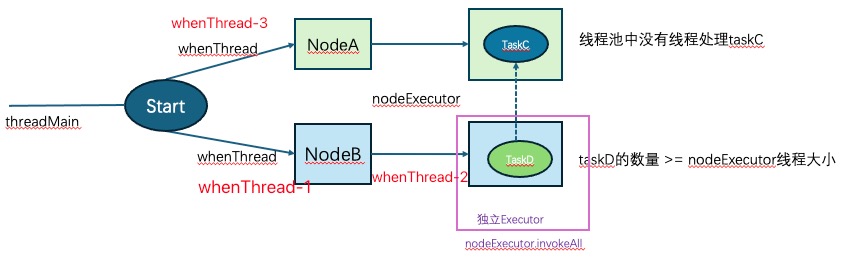
运行 flow 本身有一根主线程,当有 when 条件时,会使用内置的 when 线程池

如果不配置,默认 when 线程池 是 16个线程
并且所有 flow 的 when 条件都使用同一个 when 线程池

按上图,如果是一个线程池 =3 ,执行 flow 多次时,按图中分配,所有线程都在等待 TaskC 的完成

可当 TaskC 完成后,when 线程 都在其它地方,等待完成的任务 已经在线程线队列中

此时,只能等待 线程的 timeout , 而 默认 timeout = 3600s

解决

原因同理第一次卡住,只是第一次是因为自定义的线程池NodeExecutor,线程池任务里阻塞等待同池任务

而这一次,是 LiteFlow 底层的 when 线程池

解决的办法还是独立线程池,LiteFlow 提供了配置

在LiteFlow 的源码中,有一段注释:

// 如果设置了线程池隔离,则每个 when 都会有对应的线程池,这是为了避免多层嵌套时如果线程池数量不够时出现单个线程池死锁。用线程池隔离的方式会更加好
// 如果 when 没有超多层的嵌套,还是用默认的比较好。
// 默认设置不隔离。也就是说,默认情况是一个线程池类一个实例,如果什么都不配置,那也就是在 when 的情况下,全局一个线程池。

其实也应征了上述分析。

目前liteflow设计里when线程池,如果你不单独设置自定义线程池,那么就会用默认的线程池。而这个线程池,是所有的when共同一个。

LiteFlow从2.11.1开始,提供一个liteflow.when-thread-pool-isolate参数,默认为false,如果设为true,则会开启WHEN的线程池隔离机制,这意味着每一个when都会有单独的线程池。这个特性对于运行复杂的嵌套when时是可以提升运行速度的且规避掉一些锁的问题。

可以如下配置来开启:

1
liteflow.when-thread-pool-isolate=true

不过当前使用Liteflow 版本 还有线程池泄漏的bug,翻看源码:

在 并行 编排 时, 每个 WHEN 条件去获取 Executor 有bug。
当有 condition 时,这个bug就会被触发。

排查

怎么定位这种问题

1、在 grafana 监控面板看查看 thread 数量,是否在增长,一直增长那可能是线程池泄漏,有时会以 OOM 形式暴露

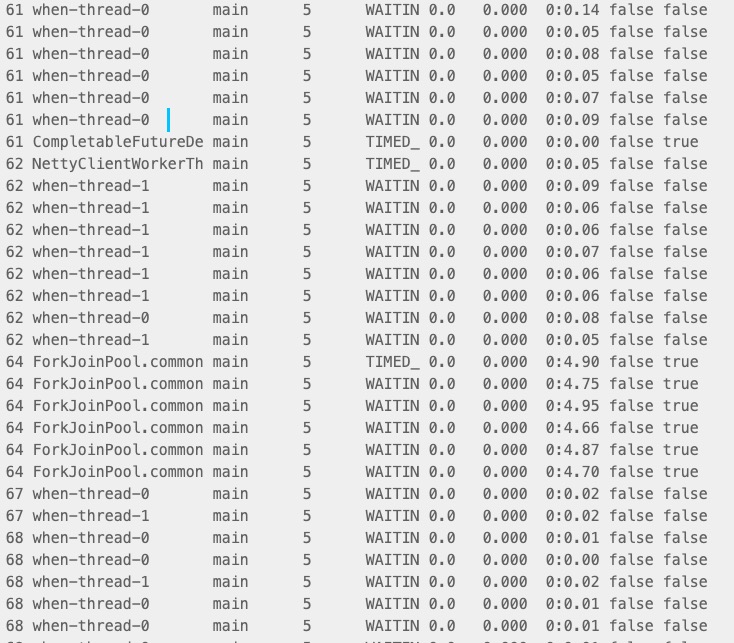
2、统计线程状态,查看大量线程处于BLOCKED/WAITING,确认线程耗尽

比如上面卡住的情况,通过线程状态,看到大量的 WAITING 线程

系统中有部分业务是使用C++实现,然后Java 通过 JNI 调用

但 C++ 只构建了 Windows 的 xxx.dll 和 Linux 的 libxxx.so 却没有 macOS 的 libxxx.dylib`

作为 Mac 用户,就麻烦了,一直在想个解决的办法,不然就得切换到Windows ,痛苦。

第一步解决本地运行问题
在本地开发完程序,可以发布到 docker 中,再进行功能性调试,解决本地不能运行问题。

在不涉及具体模块功能开发时,这算是解决问题了

但要经常进行代码开发这部分相关功能,就很麻烦。
不仅仅运行验证一下程序结果,还得开发调试,验证过程数据,总不能每一步都要加日志再发布 docker 调试,整体效率太低了。

最近找到了一种更好的方式:
Mac 上调试 JNI = 在 Linux 容器里跑 native + Mac IDEA 远程调试接进去。
Docker Desktop on Mac 跑的就是 Linux 容器,.so 能在里面正常加载。

实现方案

整体基于 JPDA(Java Platform Debugger Architecture)架构,通过 JDWP(Java Debug Wire Protocol)协议让外部调试器(如 IntelliJ IDEA)连接到正在运行的 JVM 上,实现远程断点调试、变量查看、单步执行等功能。

服务端增加 agent 参数

1、在发布 docker 时,容器 JVM 上加的 agent 参数就是开启 JDWP:

1
-agentlib:jdwp=transport=dt_socket,server=y,suspend=n,address=*:5005

下面逐段解释每个参数的作用:

-agentlib:jdwp

  • 指定加载 Java 调试代理库(Java Debug Wire Protocol Agent)。
  • 这是 JVM 内置的调试支持模块,用于与外部调试器通信。

transport=dt_socket

  • 指定调试器与 JVM 之间的通信方式为 Socket 网络传输。
  • 即通过 TCP/IP 协议进行连接,支持本地或远程调试。

server=y

  • 表示当前 JVM 作为 调试服务端,监听指定端口,等待调试器(客户端)来连接。
  • 如果设为 server=n,则 JVM 会主动去连接调试器(较少用)。

suspend=n

  • 表示 JVM 启动时 不暂停,应用程序会立即开始执行。
  • 如果设为 suspend=y,JVM 会挂起,直到调试器连接后才继续执行(常用于调试启动阶段的问题)。

address=*:5005

  • 指定调试器监听的 端口号为 5005。
  • *: 表示监听 所有网络接口(即允许来自任意 IP 的连接),这是 JDK 9 及以上版本的写法。
    • 在 JDK 8 及以下版本中,通常写为 address=5005(只监听本地)。

原理:JVM 内置的 JDWP agent 暴露一个端口,IDEA 的 “Remote JVM Debug” 连上后,按 JDWP 协议下发”设断点 / 读变量 / 单步 / 取栈帧”等命令,JVM 在断点处挂起并把线程状态回传给 IDEA,于是能在 Mac 的 IDE 里像本地一样断点调试容器里的 Java 代码。

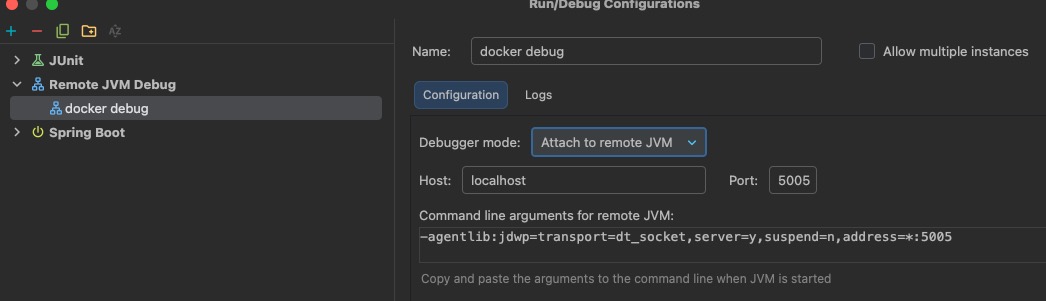
IntelliJ IDEA 接入

找到 “Remote JVM Debug” 配置入口

JPDA

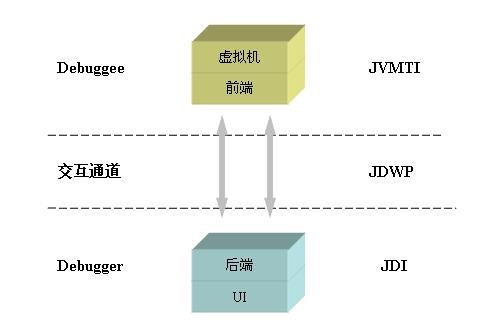
JPDA(Java Platform Debugger Architecture) 是 Java 平台调试架构的缩写,通过 JPDA 提供的 API,开发人员可以方便灵活的搭建 Java 调试应用程序。

组成模块

JPDA 主要由三个部分组成:Java 虚拟机工具接口(JVMTI),Java 调试线协议(JDWP),以及 Java 调试接口(JDI)

这三个模块把调试过程分解成几个很自然的概念:调试者(debugger)和被调试者(debuggee),以及他们中间的通信器。

被调试者运行于我们想调试的 Java 虚拟机之上,它可以通过 JVMTI 这个标准接口,监控当前虚拟机的信息;
调试者定义了用户可使用的调试接口,通过这些接口,用户可以对被调试虚拟机发送调试命令,同时调试者接受并显示调试结果。
在调试者和被调试着之间,调试命令和调试结果,都是通过 JDWP 的通讯协议传输的。

所有的命令被封装成 JDWP 命令包,通过传输层发送给被调试者,被调试者接收到 JDWP 命令包后,解析这个命令并转化为 JVMTI 的调用,在被调试者上运行。类似的,JVMTI 的运行结果,被格式化成 JDWP 数据包,发送给调试者并返回给 JDI 调用。而调试器开发人员就是通过 JDI 得到数据,发出指令

JVMTI

JVMTI(Java Virtual Machine Tool Interface)即指 Java 虚拟机工具接口,它是一套由虚拟机直接提供的 native 接口,它处于整个 JPDA 体系的最底层,所有调试功能本质上都需要通过 JVMTI 来提供。通过这些接口,开发人员不仅调试在该虚拟机上运行的 Java 程序,还能查看它们运行的状态,设置回调函数,控制某些环境变量,从而优化程序性能

JDWP

JDWP = Java Debug Wire Protocol,Java 调试线协议。它是调试器和被调试 JVM 之间通信的协议规范(由 JVM TI / JVMDI 定义)。

JDI

JDI(Java Debug Interface)是三个模块中最高层的接口,在多数的 JDK 中,它是由 Java 语言实现的。 JDI 由针对前端定义的接口组成,通过它,调试工具开发人员就能通过前端虚拟机上的调试器来远程操控后端虚拟机上被调试程序的运行

在《[[SaaS部署标准化与定制化]]一》中,落地实践中总体原则:构建时用 Maven 控制依赖是否打进包;运行时用 Spring 条件装配隔离缺失的类

看似很简单的措施,其实底层映射出不少经典设计思想:面向接口编程、SOLID中的DIP原则、DDD供应商模式

下面再谈另一种现实场景:微服务整合部署

标准化

在公有云上,我们部署的是标准化SaaS,按客户价值分类,这些服务客户是我们的 “现金奶牛“。

这类客户应该覆盖大部分的用户群体,比如 GitHub 免费用户,或是 Salesforce 标准版这样的用户。对于这类客户,目标就是降低成运营成本。比如通过自动化脚本实现低成本运维。再比如,通过自助式服务来解决服务开通等问题。

这类客户没有特殊需求,都是产品标准功能。标准化能把高昂的研发成本摊薄到海量用户上,就可以降低边际成本,实现规模化盈利。

此时,我们需要的客户数量越多越好,而从架构角度,稳定性就是关键因素。至少保证“4个9的高可用性”。

为了主业务的高可用、高性能。我们通常使用拆分、隔离原则。
在DDD拆分域中,通常分为:核心域、支撑域、通用域。

对应组织层面,就会有各个业务团队,各个中台团队,基础架构团队。把一个服务,拆分成上百个微服务来支撑整个系统的良好运行。

定制化

标准客户是”现金奶牛“,定制化就是服务于高价值客户。

如果不是高价值客户,也没必要折腾定制化。高价值也并不单单是价格,也可能是市场标杆价值

标准化部署时,为了高可用,核心业务与非核心业务要隔离,每个服务都至少需要2个pod,
为了应对突发高峰,还有冗余资源

形象一点,米国入侵战争时,别看深入敌后的就一支海豹突击队,其实后面可能有一个航母编队在支撑。

这些成本通过规模化都能拉平。而在定制化部署时,云资源是客户提供的,每次部署前,都要提前申请,而且申请是可能会被拒绝的,并且在招标时,这也是一个中标重要因素。

在公有云,如果有100个微服务,至少需要200个pod,1个pod如果至少需要1核 CPU,那至少需要200核。

这时应对方案
1、压缩单个pod资源,比如低流量服务只配置0.5核
2、减少pod数量,比如只要50个微服务,把为了灵活性,运维性的服务减掉,像配置中心服务

而业务微服务,把多个微服务整合到一个微服务中,使用本地调用平替掉远程调用,达到减少微服务部署的要求

在 Spring Boot 中实现本地调用与 Feign 远程调用的无缝切换,核心思路是面向接口编程,并结合 Spring 的条件装配机制(Conditional)。通过读取配置文件中的属性,让 Spring 容器在启动时自动决定注入本地实现还是远程代理。

我们假设项目的 GroupId 为 com.example,整体分为三个核心模块:product-api、product-core 和 order-service(消费方)。


1. 模块一:product-api(轻量级契约模块)

职责:仅存放对外暴露的接口定义、DTO/POJO 实体类、Feign 客户端接口。
依赖:极轻量,只依赖 Web 和 OpenFeign。

1
2
3
4
5
6
7
8
9
10
11

<dependencies>
<dependency>
<groupId>org.springframework.boot</groupId>
<artifactId>spring-boot-starter-web</artifactId>
</dependency>
<dependency>
<groupId>org.springframework.cloud</groupId>
<artifactId>spring-cloud-starter-openfeign</artifactId>
</dependency>
</dependencies>

核心代码:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
// 1. 纯契约接口(不带 @FeignClient 注解)
public interface ProductApi {
@GetMapping("/product/{id}")
ProductInfo getProductById(@PathVariable("id") Integer id);
}

// 2. Feign 客户端(继承契约接口)
@FeignClient(name = "product-service")
public interface ProductFeignClient extends ProductApi {
// 无需重复写 @GetMapping,直接继承自 ProductApi
}

// 3. DTO 实体类
@Data
public class ProductInfo {
private Integer id;
private String name;
}

2. 模块二:product-core(核心业务模块)

职责:存放真正的业务逻辑、数据访问层。
依赖:依赖 product-api、MyBatis、数据库驱动等。

1
2
3
4
5
6
7
8
9
10
11
12
13

<dependencies>
<dependency>
<groupId>com.example</groupId>
<artifactId>product-api</artifactId>
<version>1.0.0</version>
</dependency>
<dependency>
<groupId>org.mybatis.spring.boot</groupId>
<artifactId>mybatis-spring-boot-starter</artifactId>
</dependency>

</dependencies>

核心代码:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
// 1. 核心业务服务(实现契约接口)
@Service
public class ProductCoreServiceImpl implements ProductApi {
@Autowired
private ProductMapper productMapper;

@Override
public ProductInfo getProductById(Integer id) {
// 真正的业务逻辑只在这里写一次
return productMapper.selectById(id);
}
}

// 2. 数据访问层
@Mapper
public interface ProductMapper {
@Select("SELECT * FROM product WHERE id = #{id}")
ProductInfo selectById(Integer id);
}

3. 服务提供方:product-service(独立部署的微服务)

职责:作为独立服务运行,对外暴露 HTTP 接口。
依赖:依赖 product-core、Spring Boot Web。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
// 1. Controller 仅作为协议适配层,实现契约接口
@RestController
public class ProductController implements ProductApi {
@Autowired
private ProductCoreServiceImpl productCoreService;

@Override
public ProductInfo getProductById(Integer id) {
// 参数和路径已经在 ProductApi 中定义好了,这里直接委托给 Core
return productCoreService.getProductById(id);
}
}

// 2. 启动类(记得配置 MapperScan)
@SpringBootApplication
@MapperScan("com.example.product.core.mapper")
public class ProductServiceApplication {
public static void main(String[] args) {
SpringApplication.run(ProductServiceApplication.class, args);
}
}

4. 消费方:order-service(核心亮点:无缝切换)

职责:调用商品服务,支持通过配置一键切换本地/远程调用。
依赖:

  • 始终依赖 product-api(为了获取 ProductApi 接口和 ProductFeignClient)。
  • 按需依赖 product-core(如果配置为 local,则必须引入;如果仅用 remote,可不引入)。
1
2
3
4
5
6
7
8
9
10
11
12
13
14

<dependencies>
<dependency>
<groupId>com.example</groupId>
<artifactId>product-api</artifactId>
<version>1.0.0</version>
</dependency>

<dependency>
<groupId>com.example</groupId>
<artifactId>product-core</artifactId>
<version>1.0.0</version>
</dependency>
</dependencies>

核心代码(条件装配配置类):

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
// 消费方的配置类,负责决定注入哪个实现
@Configuration
@EnableFeignClients(basePackages = "com.example.product.api") // 扫描 Feign 客户端
public class ProductClientConfig {

// 1. 远程模式:注入 Feign 代理(Feign 本身也是 ProductApi 的实现类)
@Bean
@ConditionalOnProperty(name = "service.product.mode", havingValue = "remote")
public ProductApi remoteProductApi(ProductFeignClient feignClient) {
return feignClient;
}

// 2. 本地模式:直接注入 CoreService(跳过 Web 层,性能最高,零重复代码)
@Bean
@ConditionalOnProperty(name = "service.product.mode", havingValue = "local", matchIfMissing = true)
public ProductApi localProductApi(ProductCoreServiceImpl coreService) {
return coreService;
}
}

消费方业务代码(完全解耦):

1
2
3
4
5
6
7
8
9
10
11
// 订单服务,只认 ProductApi 接口
@Service
public class OrderService {
@Autowired
private ProductApi productApi; // Spring 会根据配置自动注入本地或远程实现

public void createOrder(Integer productId) {
ProductInfo product = productApi.getProductById(productId);
System.out.println("订单创建成功,商品名称:" + product.getName());
}
}

消费方配置文件:

1
2
3
4
# application.yml
service:
product:
mode: local # 切换为 remote 时,Spring 会自动将 Feign 代理注入到 OrderService 中

这套架构是目前微服务演进中最标准的“SDK 抽取模式”,既保留了微服务的灵活性,又兼顾了单体的高性能。

一个SaaS,但凡涉及客户现场部署场景,打包必然就会面临标准化与定制化两种路径

总有各种各样的原因来强迫架构的演化,不以架构师的意志转移

标准化

首先不管是架构师还是公司,都希望只有一个标准化。

标准化能把高昂的研发成本摊薄到海量用户上,就可以降低边际成本,实现规模化盈利。

开发团队会预埋大量的if-else或策略模式,把所有可能的变化都抽象成配置文件(如YAML、JSON)。用户通过修改配置来“定制”,但这些配置不改变程序本质,只是给同一套代码换了不同的“皮肤”或“流程顺序”

定制化

定制化的核心技术是 “模块化”与“插件化”。
开发者会设计出清晰的“内核”和“外挂”机制。基础功能标准化,但关键的业务逻辑做成可替换的“插件”或“微服务”。定制时,只需重写或新增一个插件模块,而不用动整个底层引擎。

其中插件化,类似DDD中供应商模式。

model层有接口,而具体实现在各个“供应商”

比如发消息,有微信、钉钉、飞书。

总体原则:构建时用 Maven 控制依赖是否打进包;运行时用 Spring 条件装配隔离缺失的类

Maven 层面控制依赖打包

1、把功能依赖声明为 optional

在 common/pom.xml 中,把仅部分客户使用的依赖声明为 optional:

1
2
3
4
5
<dependency>  
<groupId>com.larksuite.oapi</groupId>
<artifactId>oapi-sdk</artifactId>
<optional>true</optional>
</dependency>

作用:common 模块本身可以编译,但依赖不会传递到 main 模块

<optional>true</optional> 控制的是依赖传递性,不是“当前模块自己不打这个 jar”

含义:common 模块自己可以使用这个依赖来编译和运行,但不会把这个依赖传递给依赖 common 的其他模块

假设模块结构:

1
main  -->  depends on  -->  common  -->  javacv-platform (optional=true)
情况 不加 <optional> 加了 <optional>true</optional>
common 编译时 能使用 javacv-platform 能使用 javacv-platform
main 是否会自动继承 javacv-platform 会 不会
如果 start 想要这个依赖 什么都不用做 必须在 main/pom.xml 里显式声明

main 作为 Spring Boot 模块:默认会把所有非 optional 的传递依赖打进 fat jar。如果 common 里的 javacv-platform 是 <optional>true</optional>,main 不会自动继承它,所以最终 fat jar 里不会包含 javacv-platform,除非 start 显式引入。

在 main/pom.xml 按 profile 引入依赖

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
<profiles>
<profile>
<id>customer-a</id>
<dependencies>

<dependency>
<groupId>org.bytedeco</groupId>
<artifactId>javacv-platform</artifactId>
</dependency>
</dependencies>
</profile>

<profile>
<id>customer-b</id>

</profile>
</profiles>

<optional> 和 <scope>provided</scope> 都能“不传递给下游”,但它们对打包的影响完全不同。关键在于:

  • <optional>true</optional> 只是一个传递性开关,不改变依赖本身的 scope(默认仍是 compile)。它影响的是“下游模块会不会自动继承这个依赖”,不影响“声明模块自己运行时/打包时带不带它”。
  • <scope>provided</scope> 改变的是依赖的生命周期范围:编译/测试可见,运行时不可见,普通 jar/war 打包时不带它。但 Spring Boot 的 spring-boot-maven-plugin 默认会把 provided 也打进 fat jar(它只默认排除 system scope),所以在本项目的 Spring Boot fat jar 里,provided 并不能自动把依赖排除掉。

Spring 官方文档明确说明:

By default, both the repackage and run goals will include any provided dependencies that are defined in the project. A Spring Boot project should consider provided dependencies as container dependencies that are required to run the application.

即 spring-boot-maven-plugin 的 repackage 和 run 目标默认就会包含所有 provided 依赖,官方将其视为“运行所需的容器依赖”。

正确排除方式

若需排除特定 provided 依赖,需在插件中显式配置:

1
2
3
4
5
6
7
8
9
10
11
12
<plugin>
<groupId>org.springframework.boot</groupId>
<artifactId>spring-boot-maven-plugin</artifactId>
<configuration>
<excludes>
<exclude>
<groupId>com.aliyun.odps</groupId>
<artifactId>odps-sdk-core</artifactId>
</exclude>
</excludes>
</configuration>
</plugin>

Spring 层面隔离缺失依赖

1
2
3
4
5
6
7
8
9
@Service
@ConditionalOnClass(FFmpegFrameRecorder.class)
public class JavaCvVideoEncoderService implements VideoEncoderService {

@Override
public Map<String, Integer> encodeToMp4(String imageDir, String outputPath, double fps, int bitrate) {

}
}

关键点:

  • @ConditionalOnClass(FFmpegFrameRecorder.class):classpath 中没有 javacv 类时,该 Bean 不会被创建,也不会触发类加载。

调用方注入 Optional

1
2
3
4
5
6
7
8
@RestController
public class ReviseDataController {

private final Optional<VideoEncoderService> videoEncoder;

public ReviseDataController(Optional<VideoEncoderService> videoEncoder) {
this.videoEncoder = videoEncoder;
}

论起大运法
凡起大运,俱从所生之日,阳男阴女顺行,数至未来节。阳女阴男逆行,数已过去节,但折除三日为一岁。

阳男阴女顺运,

假如甲子年,甲己之年丙作首,正月建丙寅,初一日立春后一日生男,顺数至二月节惊蛰,且得三十日,起十岁运,顺行丁卯。

如乙丑年,乙庚之岁成为头,正月起戊寅,初一立春,十八日生女,顺数至二月惊蛰节止,得四三十二日,起四岁运,顺行己卯。余皆仿此。阴男阳女逆运。

假如乙丑年,乙庚之岁戊为头,正月起戊寅,初一日立春后十五日生男。逆数至初一立春节止,得五三十五日,起五岁运,运行丁丑。

如甲子年,甲己之年丙作首,正月雨寅,初一立春后十日生女,逆数至初一日立春止,得九日,三三单九日,起三岁运,逆行乙丑。

余皆仿此。若多一日,减一日;少一日,增一日。

【眉批:如初一日午时生,若卯时立春,便作正月;若寅时生,未交春,还上年十二月节推命。如正月初一子时生,上四刻仍作上年十二月夜子时生,下四刻方作正月初一子时推。正谓神仙难断夜子时。】

多一日,减一日;少一日,增一日

示例:

  • 如果到节气有 15 天

  • 15 ÷ 3 = 5

  • 起运年龄 = 5 岁

  • 如果到节气有 17 天

  • 17 余 2,少一日,增一日 → 18 天

  • 18 ÷ 3 = 6

  • 起运年龄 = 6 岁

  • 如果到节气有 16 天

  • 16 余 1,多一日,减一日 → 15 天

  • 15 ÷ 3 = 5

  • 起运年龄 = 5 岁

经典示例:

甲子年,甲己之年丙作首,正月丙寅,初一立春后十日生女,逆数至初一日立春止,得九日,三三单九日,起三岁运,逆行乙丑。

  • 年柱:甲子(阳年)
  • 性别:女 → 阴男阳女逆行
  • 月柱:丙寅
  • 出生日距上一个节(立春)共 9 天
  • 9 ÷ 3 = 3
  • 第一步大运:从月柱丙寅逆行一步 → 乙丑
  • 故:3 岁起运,逆行乙丑

距离关心两个向量“隔多远”,余弦相似度关心两个向量“方向像不像”。
它们让模型能做搜索、推荐、分类和聚类

欧氏距离

欧氏距离(Euclidean Distance)其实就是我们日常生活中最熟悉的 “直线距离”。它衡量的是两点之间的最短路径长度。

余弦相似度

余弦相似度通过计算两个向量之间的夹角余弦值来衡量它们的相似性。

余弦值越接近1,夹角越小,说明两个向量越相似;
余弦值越接近-1,夹角越大,说明两个向量越不相似;
余弦值为0时,两个向量正交,表示它们之间没有相关性。

在计算余弦相似度时,我们只关注向量之间的夹角,而不考虑它们的长度。
因此,即使两个向量的长度不同,只要它们同向,余弦相似度依旧能够达到 1。

余弦公式

  • A⋅B 表示向量 A 和向量 B 的点积。
  • ||A|| 代表向量 A 的长度(模)。
  • ||B|| 代表向量 B 的长度(模)。
  • θ 是两个向量之间的夹角

为什么公式中有模

上面提到向量的夹角,与向量长度无关,但公式里面为什么会出现模呢?还得去计算模?

为什么不能直接“不看模长”?

向量的“模”(长度)和“方向”是捆绑存储在一个坐标里的。比如向量 A = (3, 4):

  • 它的模长是 5 (3平方+4平方​)再开根
  • 它的方向是 53.1°

在计算机眼里,它就是一个数组 [3, 4],模和方向是混在一起的二进制数字。
你没法写一行代码说“把模去掉,只留方向”,因为数字 3 既贡献了方向,也贡献了长度。

如果你直接拿 [3, 4] 去算点积,结果里必然混着长度的影响。所以,我们必须通过数学运算把“长度”单独提取出来。

为什么公式里要“先乘起来,再除掉”?

第一步(分子:计算点积):先让两个向量发生完整的交互。此时,A的长度、B的长度、以及它们的夹角,三者全部被混在一起,揉成了一个数值(点积)。
第二步(分母:除以模长的乘积):既然点积里混杂了“A的长度 × B的长度 × 夹角”,那我就在外面强行除以“A的长度 × B的长度”。

相当于:

(∣∣A∣∣×∣∣B∣∣×cosθ)​ / ∣∣A∣∣×∣∣B∣∣ = cosθ

为什么必须“计算模长”,而不是“忽略模长”?

因为你无法凭空忽略模长,你只能用模长来抵消自身。

  • 如果你不计算分母 ∣∣A∣∣×∣∣B∣∣,你得到的就是带长度的点积,大向量永远欺负小向量。
  • 你计算分母,不是为了“看重”模长,恰恰是为了 “利用”模长去“消除”模长。

为什么不使用Math.cos(θ )

在编程中不调用自带的 Math.cos()函数,实在令人惊讶。
这是因为该函数是直接计算出夹角的余弦值,而无需先求出夹角本身。
如果使用 Math.cos(),我们就需要先用诸如 Math.acos()之类的反三角函数来求出角度,这不仅没有必要,而且计算成本更高。

为什么余弦相似度与词义有相关性

早期的实践归纳(启发式):
在早期的信息检索(如 TF-IDF、LSA 潜在语义分析)中,工程师们发现:如果把文档变成词频向量,用余弦相似度来匹配,效果出奇的好。这完全是实践归纳出来的经验法则。人们发现高维空间中的“几何邻近性”恰好对应了人类的“语义相关性”。

后期的理论证明(统计学习理论):
到了 Word2Vec 和深度学习时代,这不再仅仅是经验。学者们(如 Mikolov, Bengio 等)通过分布式假设(Distributional Hypothesis)——“上下文相似的词,语义相似”——给出了理论解释。

随后,大量的数学证明表明:通过最大化预测上下文的概率(如 Skip-gram 的负采样目标函数),模型实际上是在隐式地分解词共现矩阵(如 PMI 矩阵)。

这就从理论上证明了:为什么优化这个损失函数,最终会让相似的词在向量空间中靠近。

Reference

How does cosine similarity work?

在AI里面,常有 “把高维向量用于AI的搜索、推荐和语义理解” 的表达

这儿的高维向量是什么意思?

低维是我们生活的世界,直观但容量有限;
高维是 AI 的“大脑”,反直觉但拥有极其庞大的信息存储和分类能力。

AI 的本质,其实就是用低维的输入,在内部构建高维的向量空间,最后再输出低维的结果(比如一个分类标签或一句回答)。

而且“高维”和“低维”其实是一个相对的概念,并没有一条绝对的界线。在数学和机器学习中,它们有着不同的特性和应用场景。

什么是低维向量?(通常指 1~3 维)

低维向量就是我们日常生活中最熟悉的几何空间:

  • 1维(标量/直线):比如你的体重(70kg),或者温度计上的刻度。
  • 2维(平面):比如地图上的经纬度 (x,y)(x,y) ,或者一张黑白照片的像素矩阵。
  • 3维(立体空间):比如你所在房间的长宽高 (x,y,z)(x,y,z) ,或者一个 3D 游戏模型。

特点:在低维空间中,人类的直觉是完全适用的。两点之间直线最短,空间看起来很“空旷”,距离和角度的计算非常直观。

什么是高维向量?(通常指几十、几百到上万维)

当向量的维度 dd 变得很大时(比如 d≥100d≥100 ),我们就进入了高维空间。

  • AI 中的 Embedding:比如 OpenAI 的文本向量通常是 1536 维,图像模型(如 CLIP)的向量可能是 768 维。
  • 推荐系统:如果用 1000 个标签来描述用户偏好,这就是一个 1000 维向量。
  • 原始数据:一张 1000x1000 的彩色图片,如果直接拉平,就是一个 3,000,000 维的向量。

特点:高维空间完全反人类直觉,这也是为什么它听起来很神秘的原因。

高维空间有哪些“反直觉”的神奇现象?

高维向量之所以强大,正是因为低维做不到的事情,高维能做到:

  • 维度灾难(Curse of Dimensionality):
    在 3D 空间里,数据很容易挤在一起。但在 1000 维空间里,空间大到难以想象,所有的数据点都变得极其稀疏。这导致在高维空间中,所有点之间的距离都变得差不多远。这就是为什么高维搜索不能直接算距离,必须用特殊的算法(如 HNSW、FAISS)。
  • 空间变得像“刺猬”:
    在低维空间,两个随机向量的夹角可能是各种度数;但在高维空间,两个随机向量的夹角几乎总是接近 90 度(正交)。这意味着高维空间里有无数个互相垂直的方向,模型可以把“苹果”和“香蕉”放在完全正交的方向上,互不干扰地存储海量信息。
  • 更容易被“切开”(线性可分):
    在 2D 平面上,如果红点和蓝点像甜甜圈一样嵌套在一起,你画一条直线是切不开它们的。但在 3D 空间中,你可以用一个平面把它们切开。维度越高,数据越容易被一条直线/一个超平面分开。这就是为什么 AI 分类任务在高维向量上做得特别好。

高维和低维的相互转换(降维)

既然高维这么好,为什么我们还要关心低维?因为高维太占内存,且人类看不懂。
所以,AI 领域有一个极其重要的分支叫降维(Dimensionality Reduction),比如 PCA(主成分分析)或 t-SNE。

  • 目的:把 1000 维的向量,压缩成 2 维或 3 维。
  • 代价:压缩必然丢失信息,但好的算法能保留最核心的“结构”(比如聚类关系)。
  • 应用:我们在论文里看到的那些非常漂亮的、五颜六色的散点图(展示 AI 把猫和狗分开了),其实都是把高维向量降维到 2D 平面后画出来的。